Health Center
Monitor tag execution in real-time.
Health Center monitors your tags performance in JENTIS and notifies your team immediately when something goes wrong.
Book a demoA centralized view of tag health for every JENTIS user.
Health Center flags issues with tags so you can publish with confidence.
Real-time monitoring
See immediately when a tag fails.
No more waiting 48 hours for data to appear in Google Analytics, or discovering later that it never arrived. Health Center monitors every tag immediately after publishing and assigns it a real-time health status.
Tags are flagged when failure rates increase, failures spike unexpectedly, or triggers are dropped before execution. Active issues appear directly in the interface, so broken tags are caught in Health Center instead of showing up later as gaps in your reports.
Issue history
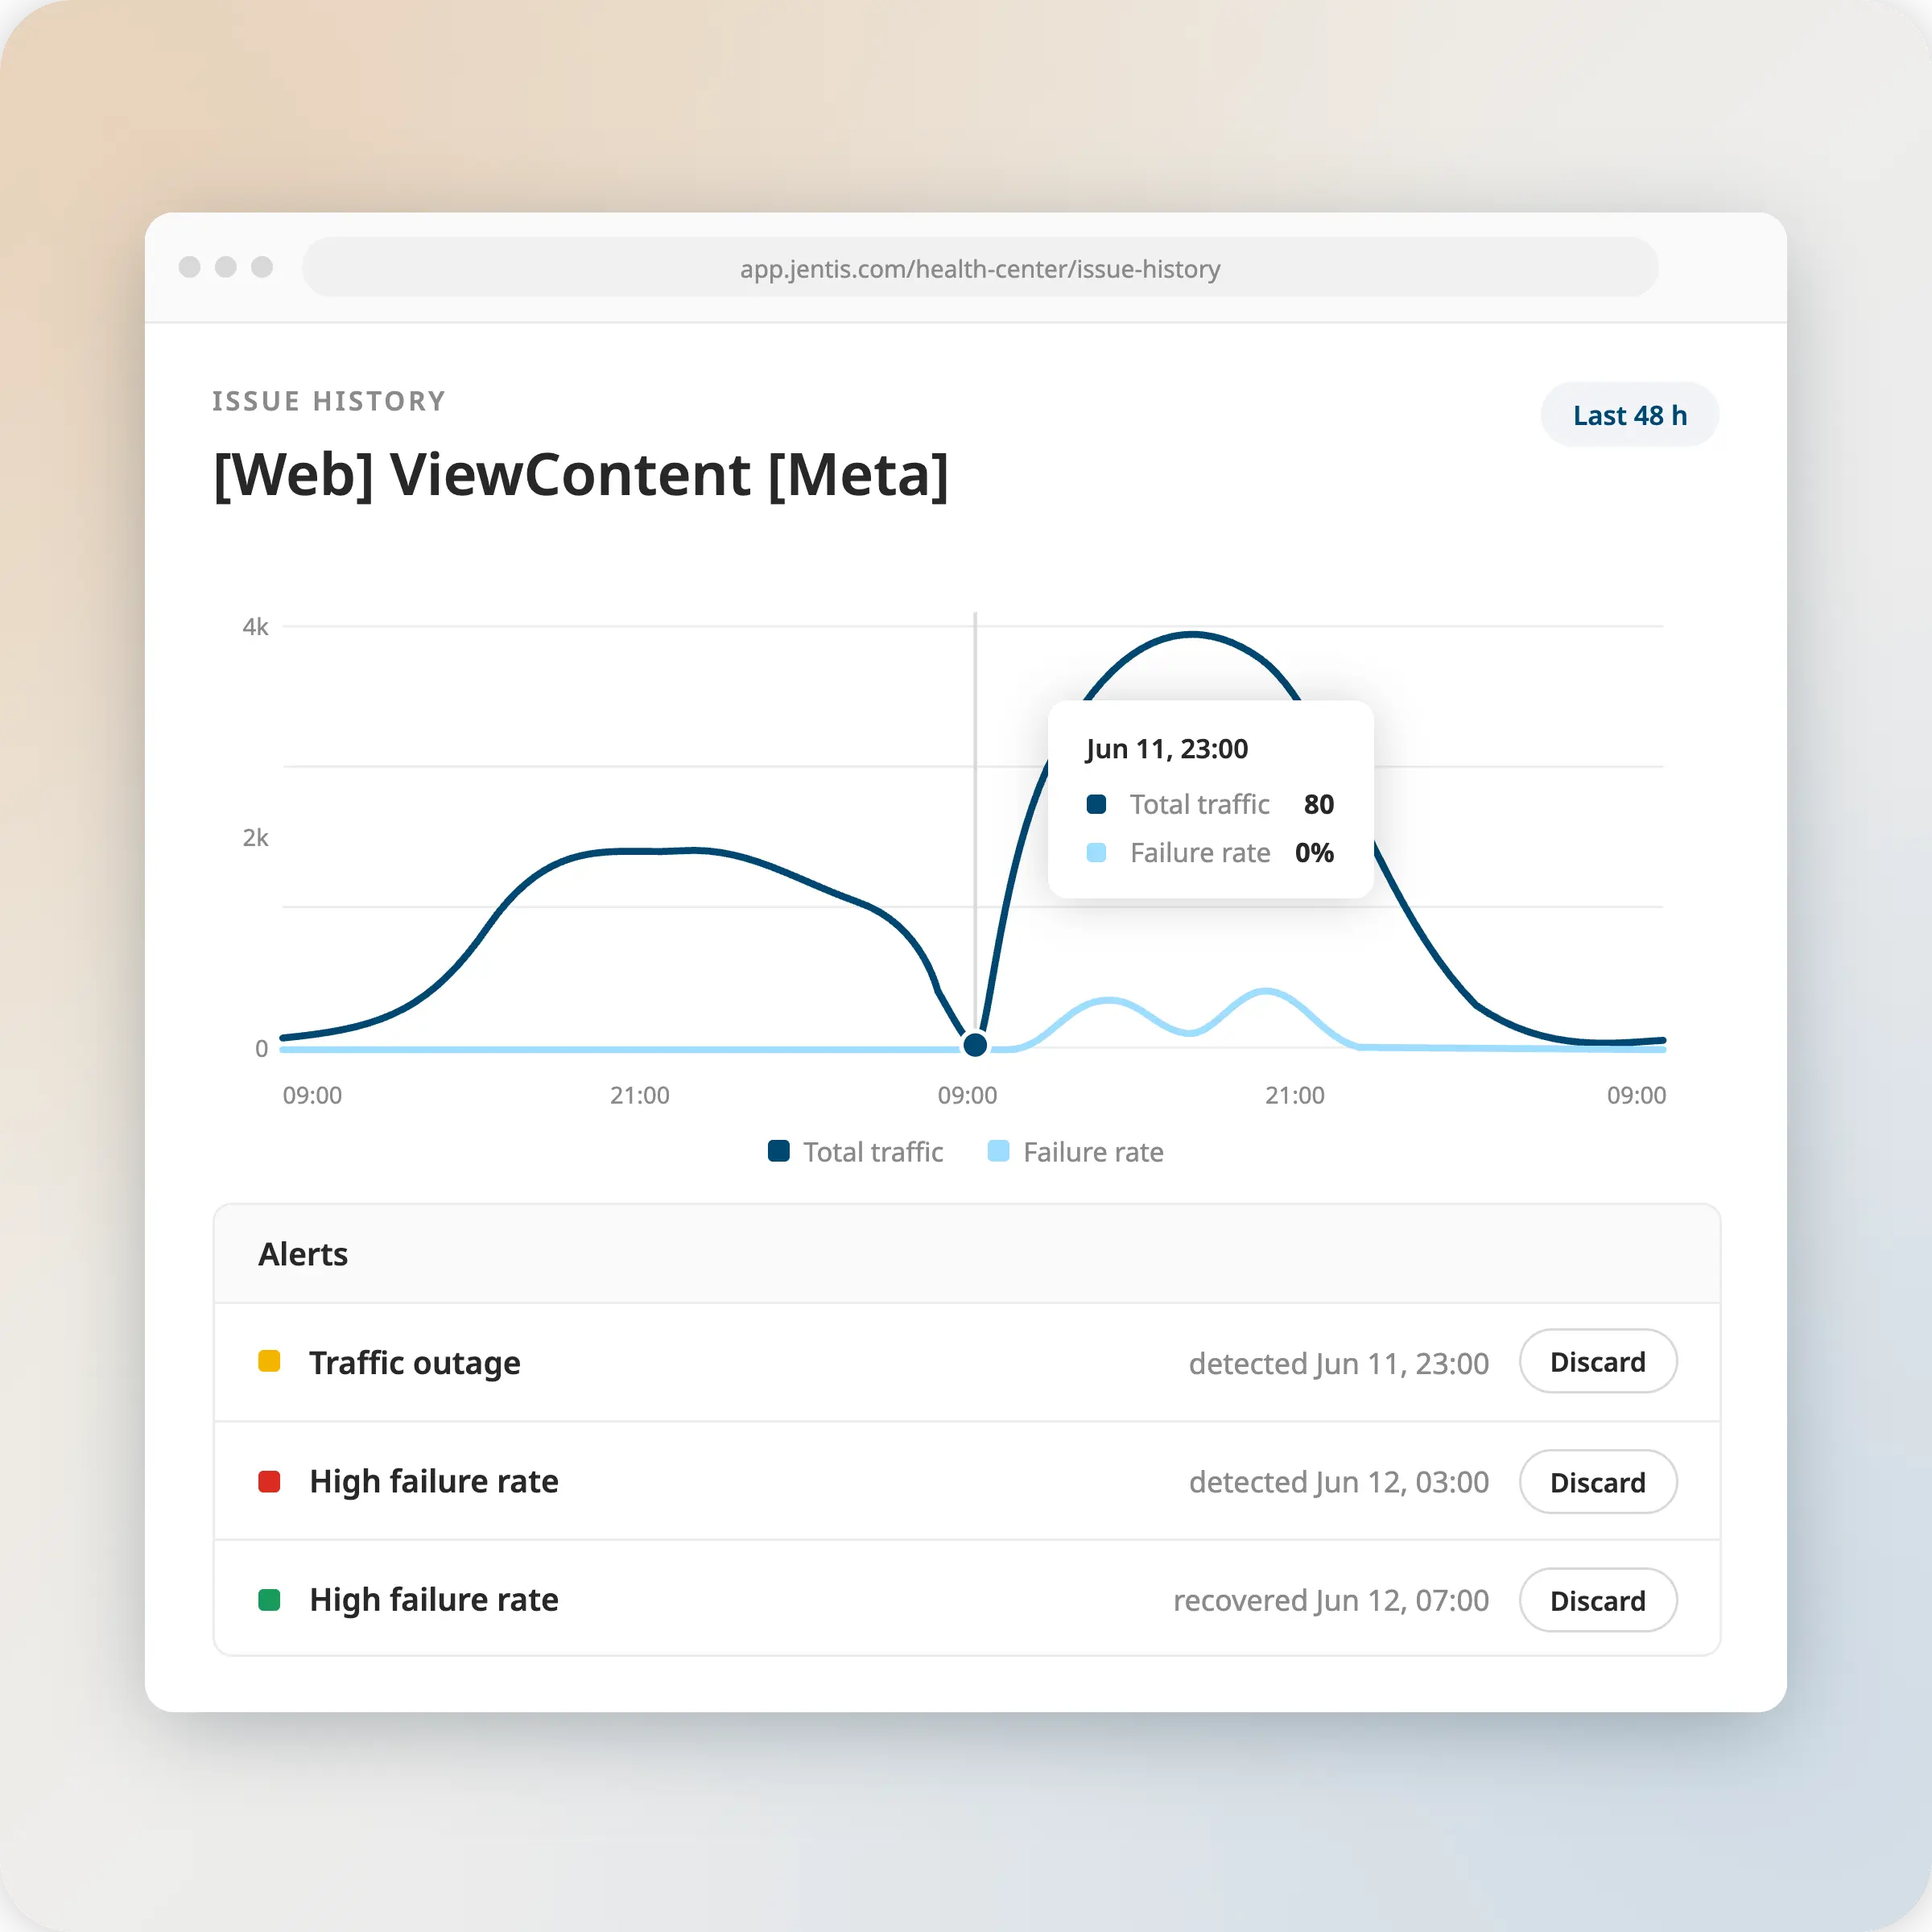
A rolling 48-hour history for each tag.
For every monitored tag, Health Center records periods of high failure rates, the number of dropped triggers, and whether an issue is ongoing or has recovered. Detected issues appear in the interface as the starting point for investigation: from an issue, you review the affected tag, its recent history, and related configuration changes.
Email notifications
Notifications for the team that maintains your tags.
Health Center sends email notifications when issues are detected. Recipients can be platform user accounts or custom email addresses. A configurable suppression window prevents repeated emails for the same ongoing issue, and failure-rate thresholds and traffic-outage alert periods can be adjusted to your setup.
Filtering
Tag health by container or by tool.
View tag health across an entire server-side container to identify broad problems, or filter by a specific tool when investigating a single integration, destination, or vendor. Filtering reduces the number of tags in view. This is particularly useful in containers with many tags, or when tag ownership is split across teams.
How it works
Health Center's detection logic and configurable thresholds.
Execution-based evaluation
Issue creation conditions
Configurable detection thresholds
Detection boundary
What customers say
format_quote
Choosing JENTIS was like moving from a standard solution to a premium one. With Synthetic Users, we saw that even the best industry practices can be outperformed by next-generation approaches, tracking 40 points more ROAS in only three weeks and achieving 94% data accuracy. It’s given us a far stronger foundation for data-driven decision-making, with the added benefit of working alongside a committed European partner.

Frequently asked questions
Lorem ipsum dolor sit amet, consectetur adipiscing elit. Suspendisse varius enim in eros elementum tristique. Duis cursus, mi quis viverra ornare, eros dolor interdum nulla, ut commodo diam libero vitae erat.
This is some headline text of an accordion
This is some headline text of an accordion
This is some headline text of an accordion
This is some headline text of an accordion
This is some headline text of an accordion
This is some headline text of an accordion
What does Health Center monitor?
Who can receive Health Center notifications?
Does Health Center fix failing tags automatically?
Can I set different alert thresholds per container in Health Center?
How far back does the issue history go in Health Center?
Will I receive an email from Health Center for every failure detected?